概要
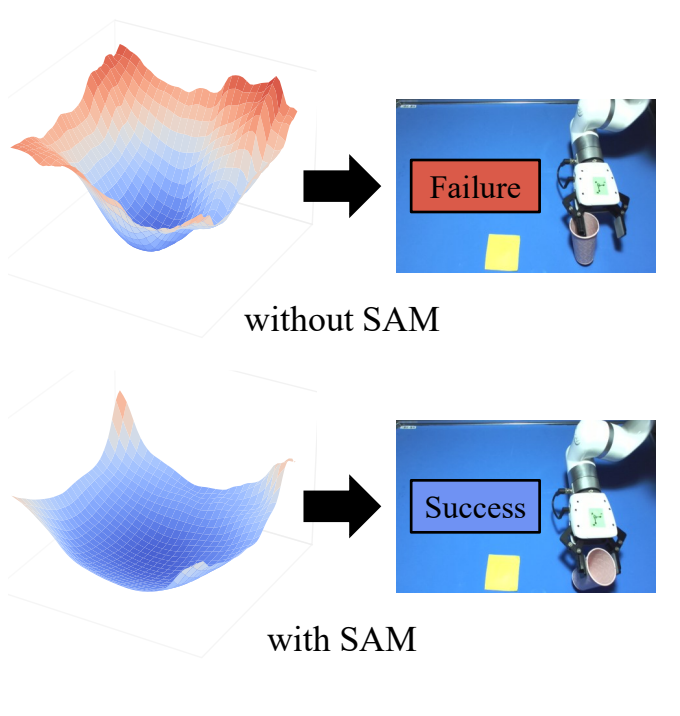
人がロボットを操作したときの画像と操作量を学習し、状況に応じて自律的に動作するロボット制御を研究しています。本研究では、時系列予測モデルSAMformerを画像に基づく模倣学習へ適用し、過学習を抑える最適化手法Sharpness-Aware Minimization(SAM)の効果を検証しました。シミュレータと実機で評価し、実機のコップ運びタスクでは、SAMを用いない場合の77.5%に対して97.5%の成功率を達成しました。
研究背景
産業用ロボットにあらかじめ動作を設定する方法では、対象物の位置や姿勢が変わると対応が難しくなります。そこで、人の実演から画像と操作の関係を学ぶ模倣学習により、環境に応じた柔軟な自律制御を実現することが期待されています。
時系列情報を扱うTransformerは模倣学習にも利用されていますが、過学習によって未知の状態に十分対応できないことが課題です。SAMformerは、SAMによって過学習を抑え、数値の時系列予測で性能改善を示したモデルです。本研究では、その有効性を高次元の時系列画像とロボット制御へ拡張して検証しました。
研究内容
SAMformerに画像エンコーダと操作量を出力するMLPを組み合わせ、連続した画像からロボットの操作量系列を予測します。実機では二眼カメラの左右画像から視差を考慮した特徴を抽出するCNN²を用い、シミュレータでは単眼画像をResNet18で特徴量に変換します。特徴の時系列的な関係をChannel-Wise Self-Attentionで捉え、SAMによってパラメータ近傍でも損失が小さい解を学習することで、汎化性能の向上を図ります。

シミュレータでは、robomimicのLift・Can・Squareの3タスクで評価しました。SAMを用いないモデルと比べ、Canの成功率は81.7%から86.0%へ、Squareは57.0%から64.5%へ向上しました。
実環境では、二眼カメラZED Miniと産業用ロボットアームxArm6を使用し、GELLOによる人の操作から100回分のコップ運びデータを収集しました。コップの初期位置を変えた40試行の評価を3つの学習シードで行った結果、平均成功率は77.5%から97.5%へ、20.0ポイント向上しました。また、損失地形やAttention行列の分析から、過学習の軽減と表現力の向上を確認しました。

一方で、SAMの近傍サイズと出力系列長の組合せによって性能が変化するため、タスクに応じた設定が必要です。今後は、より難しい実環境タスクでの有効性検証と、適切なパラメータ設定の検討を進めます。
発表文献
桝岡篤人,阪井啓紀,早崎雅人,林良和,加藤邦人,「SAMformerを適用した模倣学習によるロボットの自律制御」,第31回画像センシングシンポジウム(SSII2025),IS1-04/SO1-04,2025.