概要
人の実演からロボットの動作を学ぶ模倣学習に、時系列モデルMambaを導入し、少ないパラメータで精密なロボット制御を実現する研究です。二眼カメラの画像とロボットの姿勢情報から操作量を予測し、ペットボトルからコップへ液体を注ぐポアリングタスクを自動化しました。実験では、比較したTransformerモデルに対してパラメータ数を約3分の1に抑え、10回の実行テストすべてで人の介入なしにタスクを完了しました。
研究背景
画像に基づく模倣学習では、過去から現在までの情報を利用することで、状況に応じたロボットの動作を学習できます。一方、Transformerを用いたモデルは計算量やメモリ使用量が大きくなりやすく、限られた計算資源での運用が課題となります。
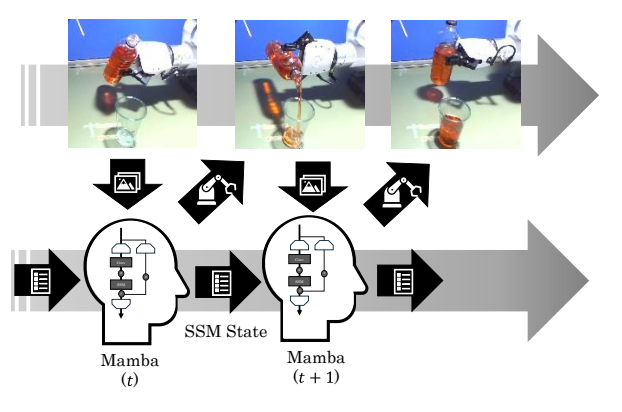
Mambaは、入力に応じて情報を選択する状態空間モデルを用い、必要な履歴を隠れ状態として保持しながら時系列を処理します。本研究ではこの仕組みをロボット制御に応用し、モデルの小型化と制御精度の両立を目指しました。液体を注ぐ作業では、容器の位置関係に加えて、傾ける角度や速度の調整が必要なため、時系列情報を活用した精密な制御が重要です。
研究内容
左右のカメラ画像をCNN²に入力し、左右の特徴の差分を利用して立体的な情報を含む特徴量を抽出します。この画像特徴とロボットの姿勢情報をMambaで処理し、Action HeadとRotate Headからそれぞれ平行移動と回転の操作量を出力します。隠れ状態を次の時刻へ引き継ぐことで、過去の情報を利用した逐次的な推論を行います。

実演データの収集では、ZED Miniの二眼映像をQuest 2に提示し、人がGeomagic Touchを操作してロボットアームを動かします。操作量に疑似ノイズを加えることで、失敗に近い状態からの修正動作も記録しました。300回の実演のうち、270回を学習、25回を検証、5回をテストに使用しました。

同じデータを用いて、Mamba、Transformer、時系列を扱わないMLPの3モデルを比較しました。実機の10回の実行テストでは、Mambaは10回、Transformerは9回でタスクを完了し、MLPは完了できませんでした。ここでの成功は、多少の液体のこぼれを許容しつつ、人の介入なしにタスクを完了した場合を指します。
パラメータ数はMambaが約5,904万、Transformerが約1億9,497万で、Mambaは比較モデルの約30%でした(論文の表1)。こぼした液体の質量はMambaが7g、Transformerが19gと報告され、Mambaは約37%に抑えられました。論文の表2では、注いだ量に対するこぼれの割合はそれぞれ1.27%と3.51%でした。
これらの結果は、今回のポアリング環境において、少ないパラメータで高い制御精度を得られることを示しています。今後は、異なるタスクや容器・液体の条件での検証と、出力する軌道をより滑らかにするモデルの改善が課題です。
発表文献
阪井啓紀,早﨑雅人,加藤邦人,「Mambaを用いた模倣学習によるロボットアームの自動制御」,第29回知能メカトロニクスワークショップ(IMEC2024),IM5-1,2024年9月.