概要
画像と言語指示からロボットの行動を生成する視覚言語行動モデル(VLA)の性能向上を目指し、行動によって生じる画像の変化を予測する「残差予測型世界モデル(ResidualWM)」を提案しました。現在の観測画像を基準として保持し、物体の移動や把持などに伴う変化を予測することで、VLAの事後学習に役立つ未来画像を生成します。追加のシミュレータロールアウトを行わずに事後学習し、ロボット操作ベンチマークLIBEROで有効性を検証しました。

研究背景
VLAは、カメラ画像と言語による指示をもとに、多様なロボット操作を学習できます。しかし、実演データを模倣するだけでは、学習時に十分に経験していない状態で誤差が蓄積し、作業に失敗することがあります。この課題に対し、行動の結果を予測する世界モデルを使い、候補行動を評価してVLAを改善する事後学習が注目されています。
従来の未来画像全体を予測する方法では、画像の大部分を占める静止した背景の再現に学習が偏り、操作の成否に関わる物体の移動や接触の変化を捉えにくい場合があります。そこで本研究では、現在画像から何が変わるかに着目した世界モデルを設計しました。
研究内容
提案するResidualWMは、過去と現在の観測画像および候補行動列を入力し、特徴空間と画素空間の両方で残差を予測します。過去画像の特徴差分から動きを捉え、行動情報と組み合わせて未来の変化を推定し、最後に現在画像へ予測した残差を加えて未来画像を生成します。
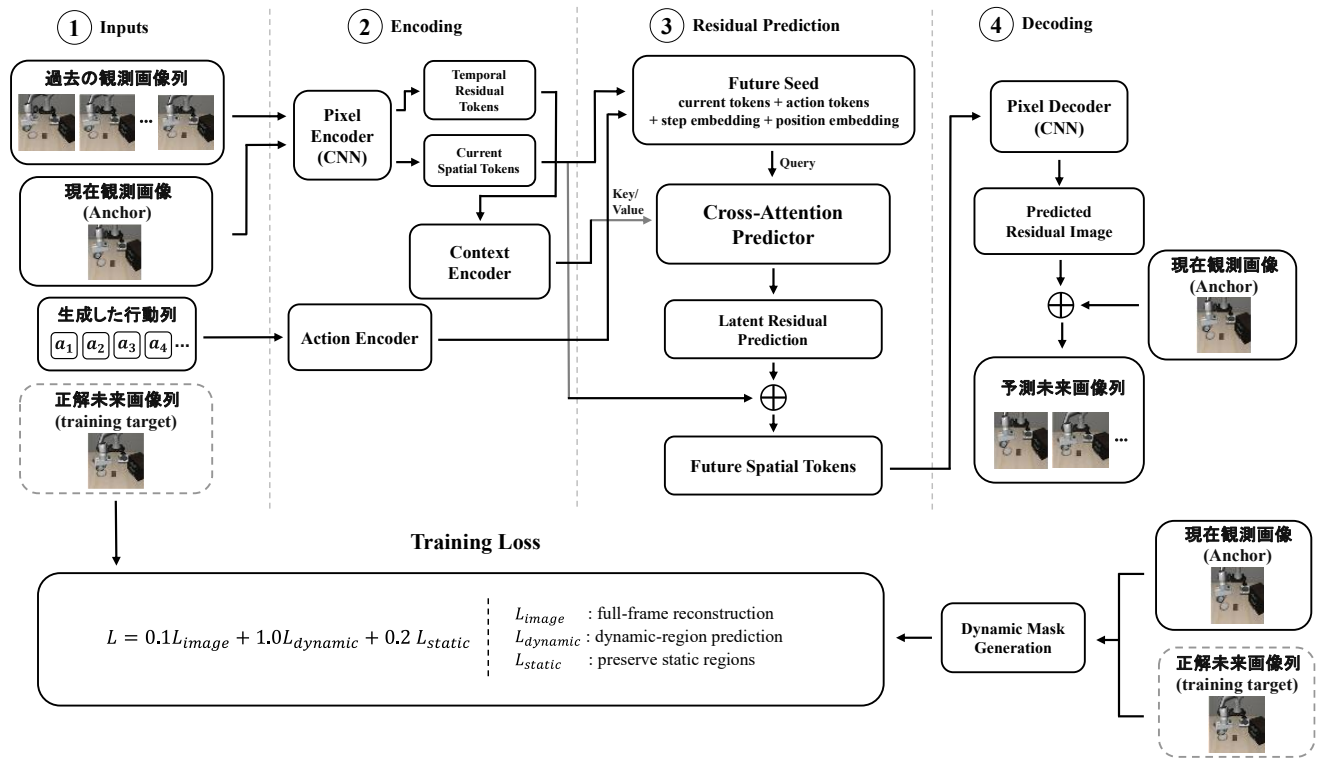
学習では、画像全体の再構成誤差に加え、動く領域の予測誤差と、静止領域を維持するための誤差を組み合わせます。これにより、操作に伴う変化の予測と背景の保持を両立します。事後学習では、VLAが生成した複数の候補行動について世界モデルで未来画像を予測し、参照画像との比較から得た報酬を使って行動生成を改善します。
LIBEROの4つのタスク群(Spatial、Object、Goal、LIBERO-10)で評価した結果、平均成功率は模倣学習のみの85.0%から、提案手法による事後学習後には85.9%に向上しました。未来画像を直接予測する比較手法の85.6%も上回り、長い行動系列を要するLIBERO-10では75.7%から77.7%への改善が得られました。これらはシミュレーション環境での結果であり、今後は実機やより長期の操作への適用を検討します。

発表文献
桝岡篤人, 加藤邦人, “視覚言語行動モデルの事後学習に向けた残差予測型世界モデル,” 第31回知能メカトロニクスワークショップ iMec2026, IMO7-2, 2026.9.