概要
ロボットが未来の状態を予測し、言葉で与えられた指示に沿って作業が前進しているかを評価することで、視覚言語行動モデル(VLA)の動作を改善する研究です。
研究背景
視覚言語行動モデル(Vision-Language-Action Model, VLA)は、カメラ画像と自然言語の指示をもとにロボットの行動を生成できます。しかし、人の操作例をまねる模倣学習だけでは、小さな動作誤差が積み重なった場合や、学習時に経験していない状態に入った場合に、タスクを最後まで完遂できないことがあります。そこで、実際のロボットを何度も動かす代わりに、行動後の未来画像を予測する「世界モデル」を使ってVLAを追加学習する方法が注目されています。従来の方法は、予測画像が正解例の画像とどれだけ似ているかを報酬にしていましたが、見た目が異なっていてもタスクを正しく進められる動作や、見た目が似ていても指示に反する動作を適切に評価できないという課題がありました。そこで本研究では、画像の一致度ではなく、状態変化の意味に基づいて行動を評価する「意味的進捗報酬」を開発しました[1]。
研究内容
提案手法では、VLAが生成した複数の候補行動を世界モデルに入力し、それぞれの行動後に生じる未来状態画像を予測します。次に、現在画像から未来状態画像への変化が、言葉で与えられたタスクの達成方向へ進んでいるかを意味的進捗報酬モデルで評価します。図1に示すように、報酬モデルは状態変化を「進行・停滞・後退」の3種類に分類すると同時に、その変化が自然言語指示と整合しているかを判定し、両方の結果を統合してVLAの学習に用います。
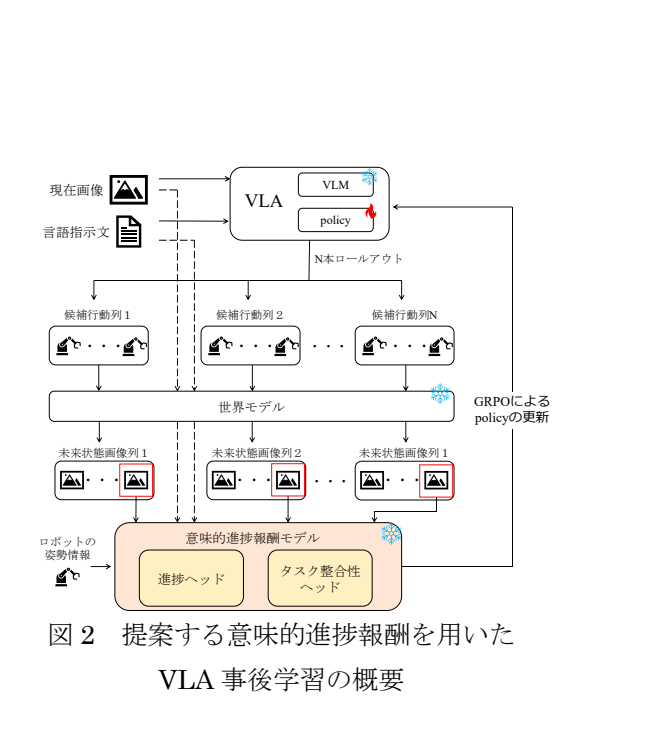
図2の報酬モデルには、現在画像、未来状態画像、言語指示、ロボットの姿勢情報を入力します。画像と言語の特徴はCLIP、姿勢情報は多層パーセプトロン(MLP)で抽出し、Transformerで統合します。現在画像と未来画像の特徴だけでなく、その差分特徴も利用することで、場面に何が写っているかと、どのような変化が起きたかを同時に捉えます。

教師データはロボット操作のデモンストレーションから作成し、図3のように未来状態の選び方や時間順序、指示文を変えることで、進行・停滞・後退・指示不整合の例を用意しました。
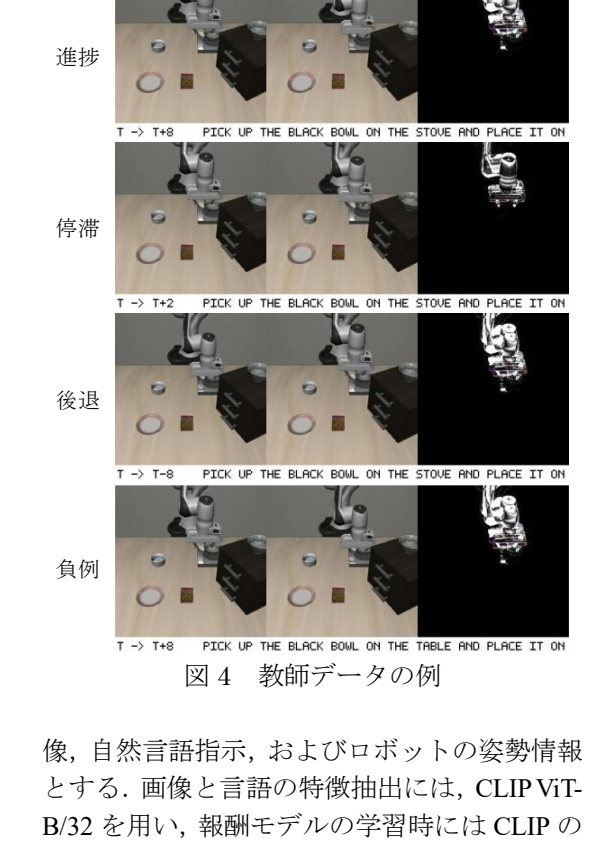
ロボット操作ベンチマーク「LIBERO」の4種類のタスク群で評価したところ、正しい進行状態と変化のない状態を区別する精度は平均96.1ポイントでした。停滞、後退、異なる指示に対しても、それぞれ平均86.0ポイント、84.6ポイント、81.4ポイントの識別精度を達成しました。さらに、従来の画像一致報酬を用いた事後学習では平均成功率が84.4ポイントだったのに対し、提案手法では85.5ポイントに向上しました。特に長い操作系列を含むタスクでは、成功率が74.7ポイントから76.6ポイントへ1.9ポイント向上しています(図4)。

この結果は、ロボットの行動を見た目の近さだけでなく、タスクの意味に沿った進捗として評価することが、長く複雑な作業の学習に有効である可能性を示しています。今後は、より多様な状態変化を安定して評価できるモデルへ発展させ、現実のロボット作業への応用を目指します。
発表文献
[1]中尾郁哉,桝岡篤人,加藤邦人:「世界モデルを用いた視覚言語行動モデルの事後学習における意味的進捗報酬」,第31回知能メカトロニクスワークショップ iMec2026(2026)