概要
木目の官能検査で視覚言語モデルが生成する判断理由を、人の判断に近い形で自動評価する研究です。理由文を小さな意味単位に分け、検査員の説明に含まれる要点がどれだけ表れているかを確かめます。
研究背景
木目の外観品質は、材色のコントラストや暗い縞の位置など、人の感覚に関わる特徴で判断されます。視覚言語モデル(VLM)は木目画像から良否だけでなく、判断理由も文章で示せます(図1)。しかし、理由の良し悪しを毎回人が確かめるには手間がかかります。さらに、同じ木目について複数の妥当な説明があり、検査員が書いた一つの理由文だけを唯一の正解として比べると、適切な説明まで低く評価してしまいます。

研究内容
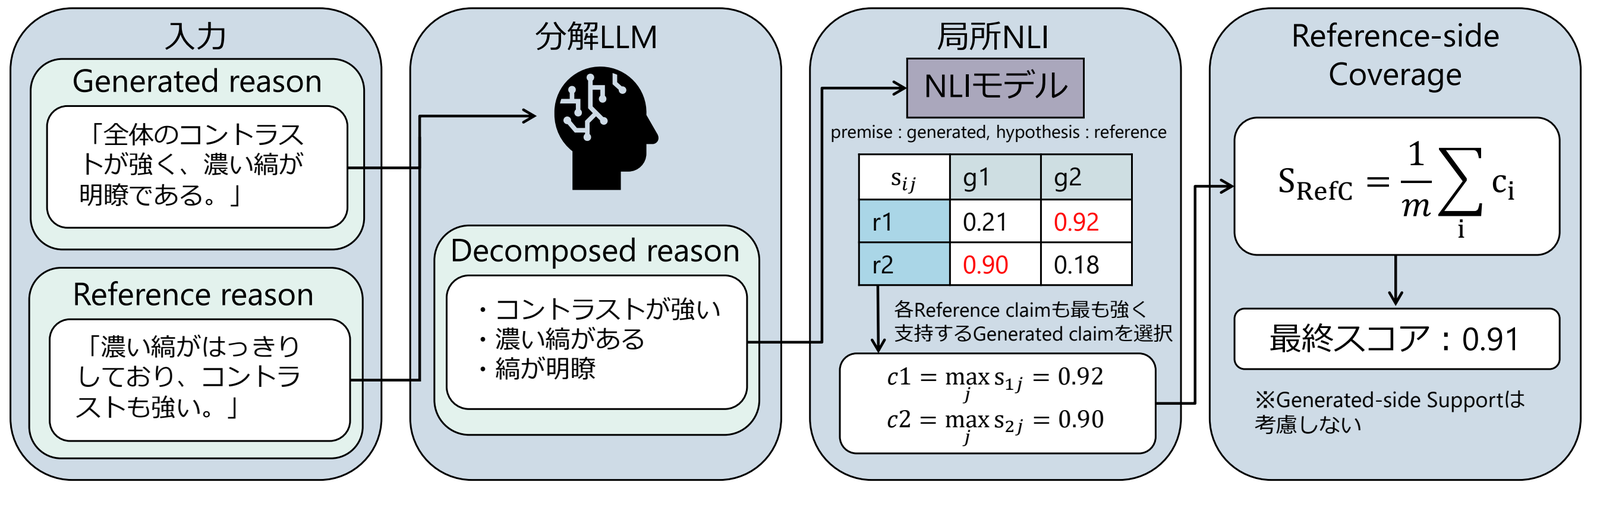
本研究では、良品と不良品を各65枚、計130枚の木目画像と、検査員による判定・理由を用います。モデル「Qwen3-VL(8B)」が生成した理由文と検査員の参照理由を、まず一つずつの意味的な主張に分解します。次に自然言語推論(NLI)という、一方の文がもう一方をどれだけ裏付けるかを調べる方法で、参照理由の各要点が生成文にどれだけ含まれるかを測ります。各要点の評価を平均した「Reference Coverage」を最終スコアとし、参照理由にない追加の説明を一律に誤りとみなさないようにします(図2)。
現時点の実験で、理由が妥当かどうかを人が判定した結果と比較すると、理由の分解に「Gemma 12B」を用いた設定では、ROC-AUCが全文を一度に比べるNLIの0.804から0.829へ、PR-AUCが0.671から0.740へ改善しました。評価順位の一致を示すSpearman相関係数も0.501から0.542へ向上しました(図3)。一方、生成文の各主張が参照理由に書かれているかまで求める方法ではPR-AUCが0.557となり、参照理由がすべての妥当な説明を網羅していないことがうかがえます。

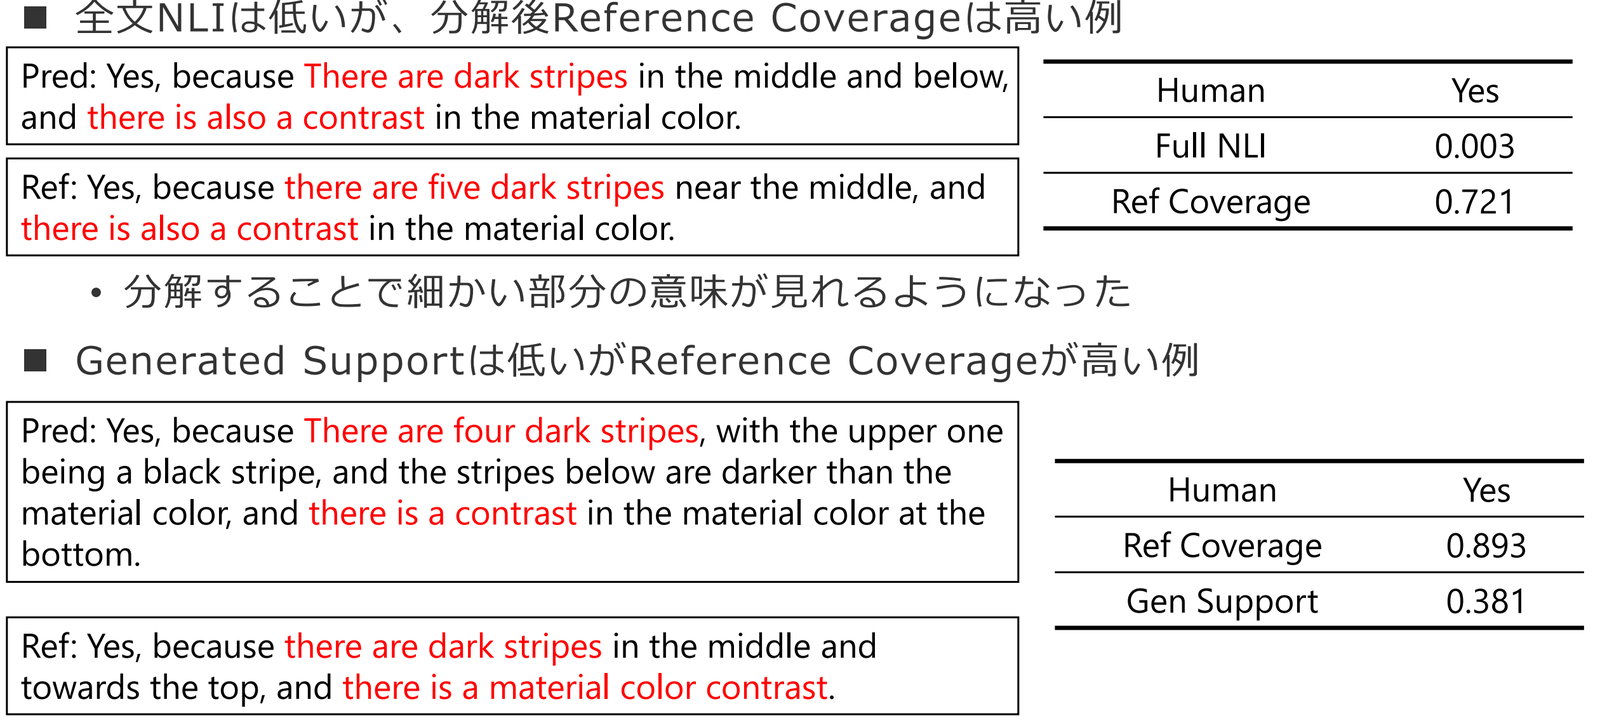
例えば、人が妥当と認めた説明でも、全文NLIのスコアが0.003にとどまる例を、提案法は0.721と評価しました(図4)。分解に使うモデルによって結果は変わるため、理由の分け方も重要です。判断理由を適切に評価できれば、木目検査の基準共有や検査員の教育に役立つ、説明できるAIの開発につながります。